


 واتساب
 يوتيوب
 انستغرام
 نبض
 ثريدز
لهجتك قد تحرمك من وظيفة... تحيّز جديد للذكاء الاصطناعي


شارك على
 مسنجر
 بريد إلكتروني
 الطباعة
شارك على




قد تتحدث الإنكليزية بطلاقة، وتقدم إجابات دقيقة في مقابلة عمل، ثم تحصل على تقييم أقل من شخص آخر لمجرد اختلاف لهجتك. هذا ما توصلت إليه دراسة حديثة أجرتها جامعة واشنطن الأميركية، وأظهرت أن نماذج متقدّمة للذكاء الاصطناعي تمنح درجات متفاوتة للمتحدثين باللغة الإنكليزية تبعاً للهجاتهم، حتى عندما يقدمون المحتوى نفسه.
ووفقاً لتقرير، نشره موقع "Tech Xplore" في 3 نوفمبر/ تشرين الثاني 2026، فإن هذه النتائج تثير تساؤلات حول عدالة استخدام الذكاء الاصطناعي لتقييم مقابلات التوظيف والعروض التقديمية والاختبارات الشفهية.
أربعة نماذج ذكاء اصطناعي تحت الاختبار
ركّز الباحثون، عقب اختبارات أولية، على أربعة نماذج متقدمة، هي "Gemini 2.5 Pro" و"Gemini 2.5 Flash" من غوغل، و"GPT-Audio 1.5" من "OpenAI"، إلى جانب النموذج مفتوح المصدر "Qwen 3 Omni".
وشملت التجربة خمس لهجات إنكليزية: الأميركية والبريطانية والصينية والهندية والنيجيرية، بهدف معرفة تأثير اختلاف النطق في تقييم المتحدثين.
واستخدمت الدراسة أصواتاً اصطناعية من شركة "ElevenLabs" لقراءة نصوص متطابقة باللهجات الخمس، بأصوات ذكورية وأنثوية، ثم طلب إلى النماذج تقييم جودة الإلقاء والمحتوى على مقياس يتراوح بين درجة واحدة وسبع درجات.
وتضمنت النصوص إجابات لمقابلات عمل، وعروضاً صفية وأكاديمية، وإجابات لاختبارات الكفاءة باللغة الإنكليزية.
اللهجتان الأميركية والبريطانية تتصدران التقييم
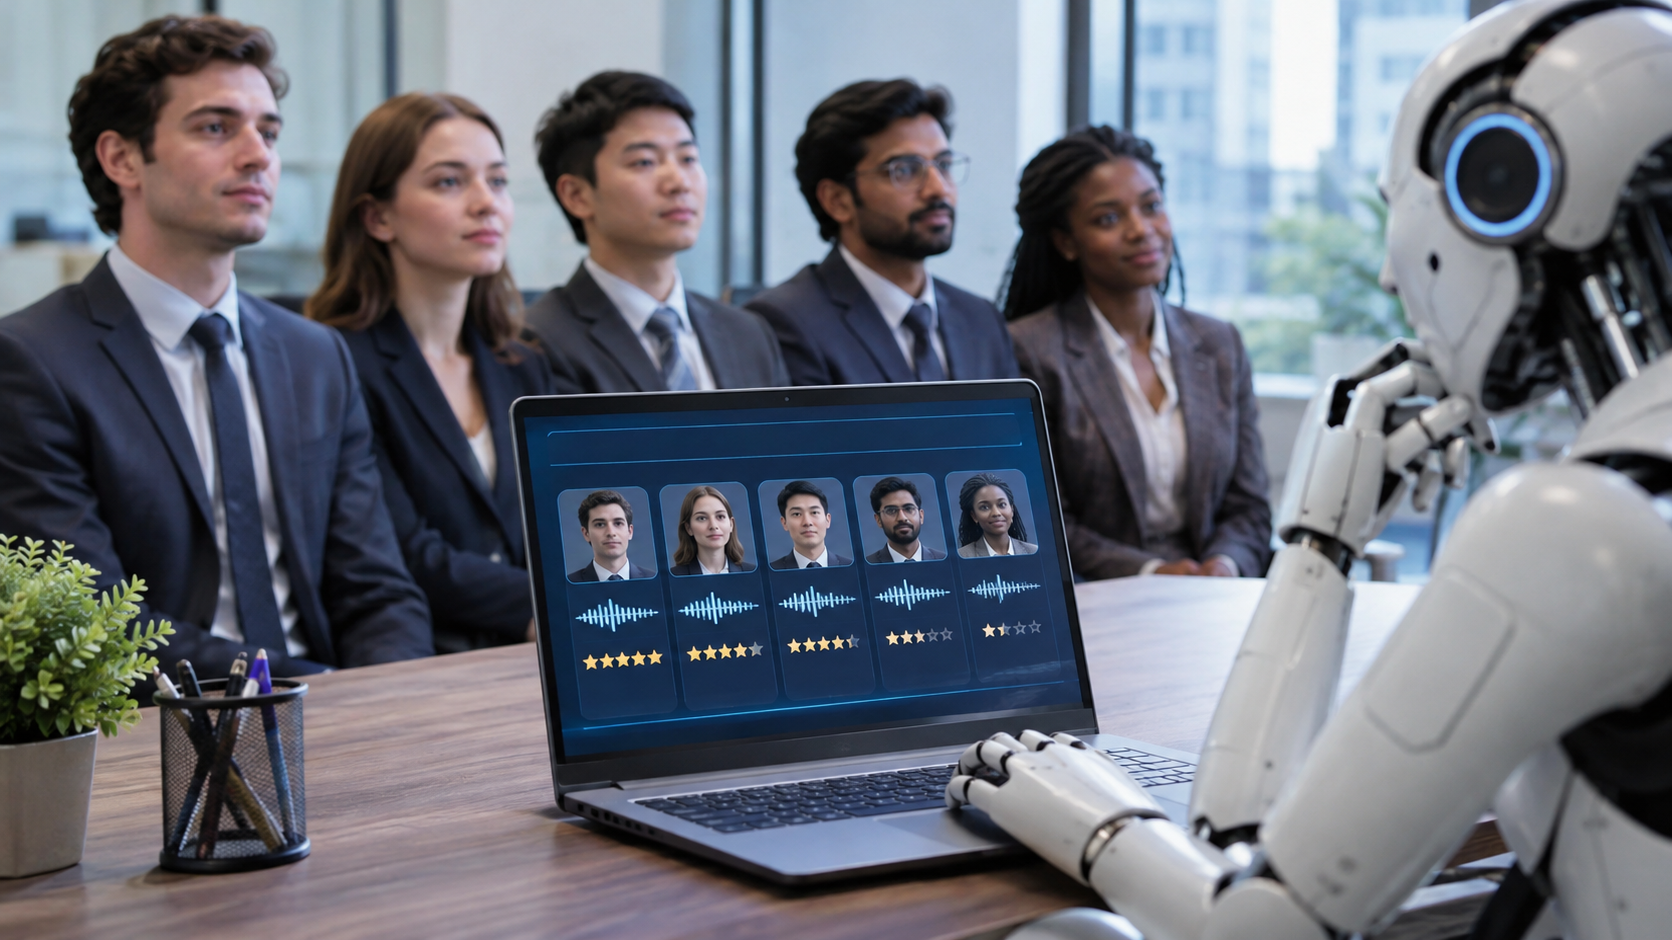
أظهرت النتائج أن النماذج الأربعة فضّلت عموماً اللهجتين الأميركية والبريطانية، بينما حصلت اللهجتان الصينية والنيجيرية على أدنى التقييمات، فيما جاءت الهندية في مرتبة متوسطة.
والمثير أن اختلاف الدرجات لم يرتبط بالضرورة بجودة الإجابات أو بقدرة النماذج على فهم الكلام، إذ استمر التحيز رغم تطابق النصوص ودقة تفريغها.
وللتحقق من النتائج، استعانت الدراسة بـ52 متحدثاً بشرياً من البلدان الخمسة، قرأ كل منهم أربع إجابات مكتوبة، وأجاب عن أسئلة إضافية دون نص مسبق.
وأظهرت النتائج تفاوتاً أكبر بين تقييمات اللهجات لدى المتحدثين البشريين، مقارنة بالأصوات الاصطناعية.
لماذا تقيّم النماذج اللهجات بصورة مختلفة؟
حللت الدراسة الخصائص الصوتية للهجات، وقاست مدى اختلافها عن النطق الأميركي، فوجدت أن اللهجات الأكثر ابتعاداً عنه حصلت في أغلب الأحيان على درجات أدنى.
وامتد التحيز إلى التفسيرات التي قدمتها النماذج، إذ قيّمت بعض المتحدثين باللهجتين الصينية والنيجيرية بأن كلامهم غير واضح أو يصعب فهمه، رغم نجاحها في تفريغه بدقة.
وتشير الدراسة إلى احتمالات عدة وراء هذه النتائج، منها نقص تمثيل بعض اللهجات في بيانات التدريب، أو وجود أوصاف سلبية للمتحدثين بها، أو اعتماد أساليب تدريب تعزز تصورات تقليدية حول النطق المهني المقبول.
مخاوف بشأن عدالة التوظيف والتعليم
تكتسب النتائج أهمية خاصة مع تزايد استخدام أدوات الذكاء الاصطناعي لتقييم المتقدمين للوظائف والاختبارات الشفهية، بما فيها اختبارات اللغة المرتبطة بالهجرة.
وتسلّط الدراسة الضوء على ضرورة عدم الاكتفاء بمتوسط الأداء العام للنماذج للحكم على عدالتها، بل إجراء اختبارات تفصيلية تشمل اللهجات والفئات المختلفة.
وتوصي بتطوير بيانات تدريب وتقييم أكثر تمثيلاً للتنوع اللغوي، بما يساعد على تحسين دقة النماذج وعدالتها.
وتتجه الأبحاث المقبلة إلى دراسة لهجات بشرية إضافية، واختلافات إقليمية داخل البلدان، إلى جانب كيفية تحليل نماذج الذكاء الاصطناعي للصوت في المجالات الطبية، ومنها أنظمة الاستجابة الآلية للطوارئ.
قدمت الدراسة بعنوان "The Cost of Sounding Different: Accent Bias in Audio Language Models" في 25 أكتوبر/ تشرين الأول 2026، خلال مؤتمر EMNLP في بودابست بالمجر.

العلامات الدالة
الأكثر قراءة